
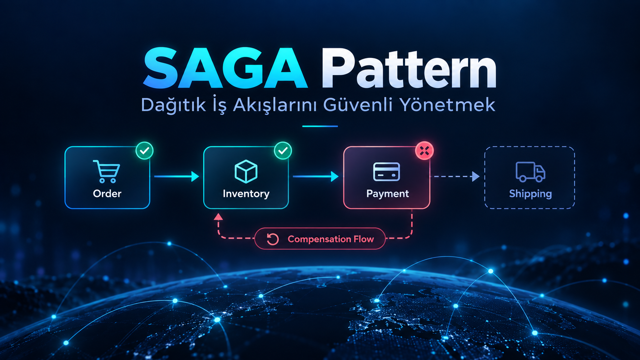
SAGA Pattern: Dağıtık Transaction Yönetimini Anlamak
Bir uygulama içinde sipariş oluşturduğumuzu, stok düşürdüğümüzü ve ardından ödeme aldığımızı düşünelim. Eğer bütün bunlar aynı veritabanında gerçekleşiyorsa işimiz oldukça rahat. Transaction açarız, gerekli güncellemeleri yaparız, her şey yolundaysa COMMIT, herhangi bir noktada hata varsa ROLLBACK.
BEGIN TRANSACTION

INSERT INTO Orders (...)
VALUES (...)

UPDATE Stocks
SET Quantity = Quantity - 1
WHERE ProductId = @ProductId

INSERT INTO Payments (...)
VALUES (...)

COMMIT
Yıllardır alışık olduğumuz model bu ve açıkçası mümkün olduğu sürece hâlâ en sevdiğim çözüm de bu. Basit, anlaşılır ve veritabanı zaten bu işi çok iyi yapıyor.
Sorun, sistem büyüyüp bu sorumluluklar farklı uygulamalara dağıldığında başlıyor.
Sipariş bir serviste, stok başka bir yerde, ödeme ise tamamen farklı bir sistemde tutuluyorsa artık tek bir BEGIN TRANSACTION ile bütün süreci güvence altına alamıyoruz. Tam burada SAGA Pattern devreye giriyor.
SAGA Pattern Nedir?
SAGA Pattern, uzun süren veya dağıtık çalışan bir iş akışını birden fazla bağımsız adıma bölerek yönetmeye yarayan bir mimari yaklaşım. Buradaki fikir aslında çok karmaşık değil. Her bileşen kendi işini yapıyor ve kendi verisini kaydediyor. Örneğin klasik bir e-ticaret akışı şöyle olabilir:
Order Service
    ↓
Inventory Service
    ↓
Payment Service
    ↓
Shipping Service
İş tarafında baktığımızda ise şu adımlar vardır:
1. Siparişi oluştur
2. Stok ayır
3. Ödemeyi al
4. Kargo kaydı oluştur
Her bölüm kendi tarafında çalışır ve kendi local transaction'ını tamamlar.
Burada dikkat edilmesi gereken nokta şu: bütün süreci kapsayan tek bir database transaction yoktur.
Yani Order tarafındaki kayıt commit edildikten sonra Payment tarafı hata verirse geriye dönüp ilk transaction'a ROLLBACK diyemeyiz.
SAGA'nın asıl meselesi tam olarak bu durumla nasıl yaşayacağımızdır.
Sorunun Kaynağı: Distributed Transaction
Monolith bir uygulamada aşağıdaki yaklaşım son derece doğaldır:
BEGIN TRANSACTION

Order oluştur
Stock azalt
Payment kaydı oluştur

COMMIT
Çünkü bütün operasyonlar aynı bağlantı ve aynı transaction kapsamında gerçekleşebilir. Dağıtık bir yapıda ise tablo değişir:
Order Service
└── OrderDb

Inventory Service
└── InventoryDb

Payment Service
└── PaymentDb
Order tarafında açılan transaction'ın Payment veritabanı üzerinde hiçbir etkisi yoktur. Bu yüzden pratikte şöyle bir yapı kuramayız:
BEGIN TRANSACTION

OrderDb işlem yap
InventoryDb işlem yap
PaymentDb işlem yap

COMMIT
Distributed transaction için Two-Phase Commit gibi eski ve hâlâ geçerli teknikler var. Ancak microservice dünyasında servis bağımsızlığı, performans, ağ hataları ve operasyonel yük gibi nedenlerle çoğu ekip bunlara mesafeli yaklaşıyor. Benim de yaklaşımım genelde şu oluyor: eğer süreci tek bir ACID transaction içinde tutabiliyorsam tutarım. Tutamıyorsam artık rollback değil, iş akışı yönetimi düşünmeye başlarım. SAGA burada anlam kazanıyor.
Local Transaction Mantığı
SAGA içindeki her adım kendi sınırları içinde tamamlanır. Örneğin:
Order Service
Sipariş oluştur
COMMIT

Inventory Service
Stok ayır
COMMIT

Payment Service
Ödeme al
COMMIT
Buraya kadar her şey güzel. Peki Payment tarafında hata olduysa ne olacak? Order çoktan kayıt edildi. Inventory tarafında stok ayrıldı. Bu iki işlemin transaction'ı kapandı. Artık klasik anlamda geri dönüş yok. İşte burada SAGA'nın en önemli kavramlarından biri devreye giriyor: Compensating Transaction.
Compensating Transaction Nedir?
Compensating transaction, daha önce başarıyla tamamlanmış bir adımın etkisini tersine çevirmek veya iş açısından telafi etmek için yapılan yeni bir operasyondur. Ben burada özellikle “rollback” kelimesini kullanmamaya çalışıyorum çünkü ikisi aynı şey değil. Örneğin akış şu noktaya kadar gelsin:
Sipariş oluşturuldu    ✓
Stok ayrıldı           ✓
Ödeme                  X
Ödeme alınamadı. Bu durumda şunu yapabiliriz:
Ödeme başarısız
      ↓
Stok rezervasyonunu iptal et
      ↓
Siparişi iptal et
Burada siparişi silmek zorunda bile değiliz. Hatta çoğu gerçek sistemde silmemek daha mantıklıdır.
Pending
↓
Cancelled
şeklinde durum değiştiririz. Bu sayede ne olduğunu sonradan görebiliriz. Aynı mantık stok için de geçerli:
Reserved
↓
Released
Yani compensation, geçmişi yok etmek değil, geçmişte yapılmış bir işin etkisini düzelten yeni bir iştir. Bence SAGA'yı anlamanın en kritik noktalarından biri tam olarak bu.
SAGA, ACID Transaction'ın Yerine Geçmez
Burada sık yapılan bir karışıklık var. SAGA, ACID transaction'ın dağıtık versiyonu değildir. ACID tarafında atomicity sayesinde şu garantiye yakınız:
Ya her şey olur
ya da hiçbir şey olmamış gibi davranılır
SAGA tarafında böyle bir garanti yok. Sistem bir süre boyunca ara durumda kalabilir. Örneğin:
Order = Created
Stock = Reserved
Payment = Pending
Bu durum tamamen normal olabilir. Bir süre sonra sonuç şu hale gelebilir:
Order = Completed
Stock = Reserved
Payment = Completed
ya da:
Order = Cancelled
Stock = Released
Payment = Failed
Dolayısıyla burada “her şey aynı anda tutarlı olsun” beklentisi yerine başka bir modele geçiyoruz. O model de eventual consistency.
Eventual Consistency Nedir?
Eventual consistency kavramı ilk başta kulağa biraz rahatsız edici geliyor. Çünkü yıllarca veritabanı tarafında bize öğretilen şey mümkün olduğunca anlık tutarlılık. Dağıtık sistemlerde ise bazen bu yaklaşım gerçekçi değil. Örneğin sipariş oluşturulduktan hemen sonra stok bilgisi henüz güncellenmemiş olabilir:
Order = Created
Stock = Henüz ayrılmadı
Biraz sonra:
Order = Created
Stock = Reserved
Aradaki kısa sürede sistem tamamen senkron değildir. Fakat süreç düzgün tasarlandıysa bir süre sonra beklenen duruma ulaşır. Eventual consistency'nin özeti aslında bu.
SAGA Sadece Microservice İçin mi?
Hayır. En sık microservice mimarisinde karşımıza çıktığı doğru, ama sadece oraya ait bir yaklaşım değil. Asıl soru şu:
Bu iş akışının tamamını tek bir ACID transaction içinde yönetebiliyor muyum?
Örneğin tek uygulama içinde şöyle bir süreç olabilir:
Database kaydı oluştur
↓
Harici ödeme API'sini çağır
↓
Rezervasyon sistemine istek gönder
↓
E-posta gönder
Burada tek uygulama kullanıyor olsak bile SQL transaction dışarıdaki ödeme sağlayıcısını geri alamaz.
Kendi veritabanımıza ROLLBACK dememiz karşı tarafın aldığı ödemeyi yok etmez.
Dolayısıyla burada da telafi mekanizmasına ihtiyaç duyabiliriz.
Bu yüzden SAGA'yı sadece “microservice pattern'i” olarak tanımlamak biraz eksik kalıyor.
Ben daha çok şöyle düşünüyorum:
Tek bir transaction sınırına sığmayan uzun veya dağıtık business process'leri yönetme yaklaşımı.
İki Temel Yaklaşım: Choreography ve Orchestration
SAGA implementasyonlarında en sık iki model karşımıza çıkar:
Choreography
Orchestration
İkisi de aynı problemi çözmeye çalışır ama kontrolün kimde olduğu değişir.
Choreography Based SAGA
Choreography yaklaşımında merkezi bir yönetici yoktur. Her servis gerçekleşen olayı yayınlar, ilgilenen diğer taraflar da bu event'i dinler. Örneğin Order Service siparişi oluşturur ve şu event'i yayınlar:
OrderCreated
Inventory bunu dinler:
OrderCreated
      ↓
Inventory Service
      ↓
StockReserved
Ardından Payment tarafı StockReserved event'ini tüketebilir:
StockReserved
      ↓
Payment Service
      ↓
PaymentCompleted
Akış şöyle ilerler:
Order Service
    |
    | OrderCreated
    ↓
Inventory Service
    |
    | StockReserved
    ↓
Payment Service
    |
    | PaymentCompleted
    ↓
Shipping Service
Bu yapı event-driven sistemlerde oldukça doğal durur. RabbitMQ, Kafka veya Azure Service Bus gibi araçlarla rahatça uygulanabilir. Basit bir event şöyle olabilir:
public record OrderCreated(
    Guid OrderId,
    Guid ProductId,
    int Quantity
);
Inventory tarafında ise:
public async Task Handle(OrderCreated message)
{
    await _inventoryService.ReserveStock(
        message.ProductId,
        message.Quantity);

    await _eventBus.PublishAsync(
        new StockReserved(message.OrderId));
}
Buraya kadar yapı temiz. Ama iş akışı büyümeye başladığında işler biraz değişiyor.
OrderCreated
    ↓
StockReserved
    ↓
PaymentRequested
    ↓
PaymentCompleted
    ↓
InvoiceCreated
    ↓
ShipmentCreated
    ↓
NotificationSent
Bir süre sonra “bu event'i kim yayıyordu, bu adım neden burada başlıyordu?” diye servis servis dolaşmaya başlayabiliyoruz. Ben choreography tarafında en çok bunu riskli buluyorum. Küçük akışlarda çok zarif. Ama iş süreci büyüdükçe kontrol dağılıyor ve sistemi zihinde takip etmek zorlaşıyor.
Orchestration Based SAGA
Orchestration yaklaşımında ise akışı yöneten merkezi bir bileşen vardır. Buna genelde Saga Orchestrator denir. Orchestrator hangi adımın ne zaman çalışacağını bilir.
Saga Orchestrator
      ↓
Create Order
      ↓
Reserve Stock
      ↓
Take Payment
      ↓
Create Shipment
Bir yerde hata olduğunda hangi telafi adımlarının çalışacağını da o belirler. Örneğin ödeme başarısızsa:
Payment Failed
      ↓
Release Stock
      ↓
Cancel Order
Bu yapı bana özellikle uzun business flow'larda daha okunabilir geliyor. Çünkü süreci tek bir yerde görebiliyoruz. State machine mantığıyla düşündüğümüzde:
Started
   ↓
OrderCreated
   ↓
StockReserved
   ↓
PaymentCompleted
   ↓
Completed
Hata durumunda:
PaymentFailed
   ↓
StockReleased
   ↓
OrderCancelled
   ↓
Failed
.NET tarafında MassTransit gibi çözümler Saga State Machine için hazır yapılar sunuyor. Basitleştirilmiş state modeli şöyle olabilir:
public class OrderSagaState
{
    public Guid CorrelationId { get; set; }

    public string CurrentState { get; set; }

    public Guid OrderId { get; set; }
}
Burada state'i saklamak önemli. Çünkü bu tür akışlarda olaylar aynı anda gerçekleşmeyebilir. Bir mesaj birkaç saniye sonra da gelebilir, birkaç dakika sonra da. Uygulamanın “bu sipariş hangi aşamadaydı?” sorusuna cevap verebilmesi gerekir.
Choreography mi Orchestration mı?
Bu soruya ezbere cevap vermek doğru değil. Ben seçim yaparken sürecin uzunluğuna ve iş kuralının ne kadar merkezi olduğuna bakıyorum. Örneğin:
OrderCreated
↓
SendEmail
gibi iki adımlı basit bir akışta orchestrator kurmak bana gereksiz gelir. Choreography burada daha doğal. Ama süreç şöyle uzuyorsa:
Order
→ Inventory
→ Payment
→ Invoice
→ Shipment
→ Notification
ve aralarda bir sürü hata senaryosu varsa merkezi bir orkestrasyon katmanı işleri ciddi şekilde kolaylaştırabilir. Bunun da bedeli var tabii. Bu kez orchestrator sistemin önemli bir parçası haline geliyor ve kendi state yönetimi ortaya çıkıyor. Yani burada yine klasik cevap geçerli: It depends. Ama en azından neye göre “depends” dediğimizi bilmek önemli.
Gerçek Zorluk Compensation Yazmak Değil
SAGA'yı ilk gördüğümüzde konu genellikle şu kadar basit anlatılıyor:
A
↓
B
↓
C

C hata verirse
B'yi geri al
A'yı geri al
Kağıt üzerinde gayet güzel. Production tarafına geçtiğimizde ise asıl problemler biraz daha farklı. Mesela:
Aynı event iki kere gelirse ne olacak?

Mesaj broker'a yazıldı ama consumer alamadıysa?

Consumer işi yaptı ama ACK gönderemeden çöktüyse?

Compensation da hata verirse?

Ödeme çağrısı timeout olduysa para çekildi mi çekilmedi mi?

Servis restart olduğunda akış nereden devam edecek?
Benim deneyimimde SAGA'nın zor kısmı state machine çizmek değil. Bu kenar durumları güvenilir şekilde yönetmek.
Idempotency Olmadan Olmaz
Dağıtık sistem tasarlarken aynı mesajın birden fazla kez gelebileceğini kabul etmek gerekiyor. Örneğin:
PaymentRequested
mesajı Payment Service'e iki kez ulaşabilir. Her seferinde ödeme almaya çalışırsak sonuç tahmin edilebilir: müşteriden iki kez para çekebiliriz. En basit haliyle şöyle bir koruma düşünülebilir:
if (await PaymentAlreadyProcessed(orderId))
{
    return;
}

await ProcessPayment(orderId);
Ama gerçek sistemde bu kadar basit değil.
İki mesaj aynı anda gelirse iki taraf da ilk kontrolden geçebilir.
Bu yüzden unique constraint, transaction sınırı ve concurrency kontrolü gibi önlemleri birlikte düşünmek gerekir.
Örneğin OrderId için unique kayıt oluşturmak çoğu zaman daha sağlam bir yaklaşımdır.
Retry Her Zaman Çözüm Değildir
Distributed sistemlerde her hata gerçek bir business failure değildir. Payment API timeout verdi diye ödeme başarısız olmuş olmayabilir. Belki karşı taraf işlemi yaptı ama cevap bize ulaşmadı. Burada retry mantığı devreye girer:
Payment Request
     ↓
Timeout
     ↓
Retry
     ↓
Success
Ama bu da idempotency ile beraber düşünülmeli. Aksi halde retry mekanizması problemi çözmek yerine aynı işlemi birkaç kez gerçekleştirebilir. Bu yüzden “retry ekledik, tamamdır” yaklaşımı özellikle ödeme ve rezervasyon tarafında tehlikeli olabilir.
Timeout'u Baştan Tasarlamak Gerekir
Bir SAGA sonsuza kadar beklememeli. Örneğin stok ayrıldı ama ödeme tarafı hiçbir cevap vermedi. Bir noktada sistem karar vermek zorunda:
Stock Reserved
     ↓
Payment Pending
     ↓
5 dakika geçti
     ↓
Saga Timeout
     ↓
Release Stock
Bu yüzden timeout süreleri teknik parametre değil, çoğu zaman business kuralıdır. Bir otel rezervasyonu 15 dakika tutulabilir. Bir hisse emri saniyeler içinde sonuçlanmak zorunda olabilir. Bir kargo işlemi saatler sürebilir. Dolayısıyla tek bir standart süre yok.
Compensation Her Zaman “Eski Haline Döndürmek” Değildir
Bence SAGA tarafındaki en önemli yanlış anlamalardan biri de bu. Bazı işlemlerin gerçek anlamda geri dönüşü yoktur. Örneğin e-posta gönderdik:
SendEmail()
Bunu geri alamayız. Kullanıcının inbox'ından mesajı silemeyiz. Yapabileceğimiz şey yeni bir bilgilendirme göndermektir:
SendCorrectionEmail()
Aynı durum kargo için de geçerli.
Kargo firması paketi teslim aldıysa CancelShipment belki sistemde bir flag değiştirmekten ibaret değildir.
Çağrı merkezi, iade süreci veya manuel operasyon devreye girebilir.
Bu nedenle compensation'ı teknik rollback olarak değil, business telafisi olarak düşünmek çok daha doğru.
Saga State Nerede Tutulmalı?
Özellikle orchestration modelinde sürecin hangi noktada olduğunu bir yerde saklamak gerekir. Örneğin:
SagaId: 71
OrderId: 15038
State: PaymentPending
StockReserved: true
PaymentCompleted: false
Bunun kalıcı olması gerekir. Çünkü uygulama restart olabilir.
Application crash

↓ restart

Saga State:
PaymentPending

↓ devam et

Payment sonucunu bekle
Sadece memory üzerinde tuttuğumuz bir state servis kapanınca kaybolur. Production seviyesinde bu pek kabul edilebilir değil. Bu yüzden Saga persistence konusu tasarımın başından düşünülmeli.
Correlation ID Küçük Görünüyor Ama Hayat Kurtarıyor
Bir iş akışı birkaç servisten geçtiğinde logları takip etmek zorlaşmaya başlıyor. Örneğin aynı sipariş için:
Order Service
Inventory Service
Payment Service
Shipping Service
hepsi ayrı log yazıyor. Bunları birbirine bağlamak için correlation ID kullanmak çok değerli.
{
  "correlationId": "9ad03ad1-4f48-45da-aaf2-e93d084eb45e",
  "orderId": 1541,
  "event": "StockReserved"
}
Log tarafında da aynı bilgiyi taşıdığımızda:
Order Service      correlationId=ABC
Inventory Service  correlationId=ABC
Payment Service    correlationId=ABC
Shipping Service   correlationId=ABC
production'da tek bir siparişin tüm yolculuğunu takip etmek mümkün hale geliyor. Bu detay geliştirme sırasında pek önemli görünmeyebilir. Ama gece yarısı “bu ödeme neden iki kere alınmış?” diye log bakarken ne kadar değerli olduğunu anlıyorsunuz.
Outbox Pattern Neden SAGA ile Birlikte Anılıyor?
SAGA konuşurken Outbox Pattern'ın da sürekli karşımıza çıkmasının sebebi çift yazma problemidir. Örneğin Order Service şöyle çalışıyor olsun:
1. Database'e Order kaydet
2. RabbitMQ'ya OrderCreated event'i gönder
Database kaydı başarılı oldu.
Order INSERT
COMMIT
Tam bu anda uygulama kapandı. RabbitMQ mesajı gönderilemedi. Sonuç:
Order mevcut
ama OrderCreated event'i yok
Inventory tarafı bu siparişin varlığından hiçbir zaman haberdar olmayabilir. Outbox Pattern burada database kaydıyla yayınlanacak event bilgisini aynı local transaction içine alır.
BEGIN TRANSACTION

INSERT Order

INSERT OutboxMessage

COMMIT
Sonrasında ayrı bir worker Outbox'taki mesajları broker'a taşır. Bu yüzden gerçek bir SAGA implementasyonunda Outbox, retry, idempotency ve message delivery gibi konular birbirinden bağımsız düşünülmemeli. Hepsi aynı güvenilirlik probleminin farklı parçaları.
SAGA Ne Zaman Kullanılmalı?
Her microservice gördüğümüz yere SAGA koymak doğru değil. Hatta bana göre önce tam tersini düşünmek gerekiyor. Bu problemi daha basit çözebilir miyim? Eğer iki tablo aynı SQL Server içindeyse ve tek transaction ile işi bitirebiliyorsam neden SAGA kurayım? Normal transaction daha kolaydır. Daha hızlı anlaşılır. Daha az hata noktası vardır. SAGA ise beraberinde yeni sorumluluklar getirir:
State yönetimi
Compensation
Retry
Timeout
Idempotency
Monitoring
Distributed tracing
Message delivery
Bunların hepsi geliştirme ve operasyon maliyeti demek. Bu yüzden SAGA'yı genellikle gerçekten farklı sistemler arasında iş bütünlüğü sağlamamız gerektiğinde düşünmek daha mantıklı. Örneğin:
Sipariş
Ödeme
Stok
Kargo
Rezervasyon
Finansal işlemler
gibi birkaç bağımsız sistemi bir araya getiren süreçler iyi adaylar.
Ben Nasıl Karar Veriyorum?
Böyle bir yapıyla karşılaştığımda önce şu soruyu soruyorum:
Bu sürecin tamamını tek bir ACID transaction içinde güvenilir şekilde yönetebilir miyim?
Cevap evetse mesele büyük ihtimalle bitmiştir. Normal database transaction kullanırım. Cevap hayırsa ikinci soruya geçerim:
Aradaki adımlardan biri başarısız olduğunda daha önce yapılan işleri business seviyesinde telafi etmem gerekiyor mu?
Cevap yine evetse SAGA ciddi bir aday haline gelir. Kabaca:
Tek transaction mümkün mü?
        |
       Evet
        ↓
ACID Transaction

        |
       Hayır
        ↓
Bağımsız sistemler var mı?
        |
       Evet
        ↓
Compensation gerekiyor mu?
        |
       Evet
        ↓
SAGA düşünülebilir
Bu kadar basit bir karar ağacı çoğu durumda yeterli bir başlangıç noktası oluyor.
SAGA'nın Gerçek Maliyeti
SAGA'nın çözdüğü problem zor. Dolayısıyla çözümün de tamamen ücretsiz olması beklenmemeli. Artık sadece:
İşlem başarılı mı?
sorusunu sormuyoruz. Şunlarla da uğraşıyoruz:
Şu anda hangi aşamadayız?

Hangi adımlar tamamlandı?

Hangileri geri alınmalı?

Mesaj kayboldu mu?

Tekrar geldi mi?

Retry güvenli mi?

Timeout oldu mu?

Compensation başarısızsa ne yapacağız?

Servis restart olduğunda süreç nereden devam edecek?
Bu yüzden sadece “microservice kullanıyoruz” diye SAGA eklemek bana doğru gelmiyor. Önce gerçekten distributed business transaction problemi olup olmadığına bakmak gerekiyor.
Sonuç
SAGA Pattern'ın temel fikri karmaşık değil. Tek bir transaction ile kapsayamadığımız iş akışını küçük, bağımsız adımlara bölüyoruz. Her adım kendi sorumluluğunu tamamlıyor. Bir yerde hata oluşursa geçmişte yapılan işi teknik olarak rollback etmeye çalışmak yerine, etkisini business seviyesinde telafi eden yeni operasyonlar çalıştırıyoruz. Asıl karmaşıklık bundan sonra başlıyor. Idempotency, retry, timeout, Outbox Pattern, message delivery, state persistence ve correlation ID gibi konular devreye girdiğinde SAGA'nın yalnızca birkaç event yayınlamaktan ibaret olmadığını görüyoruz. Ben bu yüzden SAGA'yı bir “microservice özelliği” olarak değil, tek transaction sınırına sığmayan business process'leri yönetme yaklaşımı olarak görmeyi daha doğru buluyorum. Doğru yerde kullanıldığında gerçekten güçlü. Ama klasik bir database transaction'ın rahatça çözeceği probleme SAGA eklemek de sistemi gereksiz yere zorlaştırmanın en hızlı yollarından biri.